Em 30 segundos
Os jornais norte-americanos The Seattle Times e Newsday abriram um processo por direitos autorais contra a OpenAI e a Microsoft na Corte Distrital dos Estados Unidos para o Distrito Sul de Nova York. A ação afirma que as empresas copiaram reportagens dos sites dos dois veículos, inclusive material restrito a assinantes, para treinar e operar o ChatGPT, o Microsoft Copilot e os recursos de inteligência artificial do Bing. Os jornais pedem indenização e a destruição das cópias, das bases de treino e dos modelos que incorporam esse conteúdo. As duas empresas negam irregularidade.
A ação foi protocolada nesta semana e ganhou repercussão em 5 de setembro. Ela não é a primeira do gênero: o The New York Times processou as mesmas duas empresas em 2023, e desde então a lista de veículos que foram à Justiça cresceu.
O que chama a atenção neste caso não é o ineditismo, e sim o que está sendo pedido. Os jornais não querem apenas dinheiro. Querem que o material derivado das reportagens deixe de existir — incluindo os modelos treinados com ele.
Para quem contrata software, essa é a parte que importa. Uma disputa sobre a origem dos dados de treino é, no fundo, uma disputa sobre a base jurídica das ferramentas de IA que milhares de empresas já usam.
O que o processo por direitos autorais alega
A petição sustenta que OpenAI e Microsoft varreram sistematicamente os sites dos dois jornais e contornaram o paywall — o bloqueio que libera o texto completo apenas para assinantes. Segundo a ação, esse conteúdo foi incorporado aos conjuntos de dados usados para treinar e operar os produtos de IA das duas empresas.
A partir daí, os jornais listam três prejuízos. O primeiro é a reprodução: os produtos conseguiriam devolver trechos das reportagens ou paráfrases próximas do original, sem que o leitor precise visitar o site do veículo.
O segundo é econômico. Se a resposta da ferramenta substitui a leitura da matéria, cai o tráfego, cai a receita de publicidade digital e cai a necessidade de assinar o jornal.
O terceiro é reputacional, e é o menos comentado. A ação acusa as empresas de diluição de marca por conteúdo fabricado e atribuído falsamente aos dois veículos — ou seja, o modelo inventa uma informação e a apresenta como se fosse reportagem do Seattle Times ou do Newsday.
Em um trecho da petição citado pelo TechCrunch, os jornais comparam o arranjo a uma cobra comendo o próprio rabo.
Produtos de IA como o ChatGPT e o Copilot são apresentados como produtores de conteúdo, mas na prática são consumidores vorazes, devorando conteúdo escrito por humanos.
Alan Fisco, presidente do The Seattle Times, resumiu a posição do jornal ao dizer que a empresa precisa defender um conteúdo que custa milhões de dólares por ano para produzir de ser usado sem consentimento nem compensação.
O pedido de destruição dos modelos é o ponto mais duro
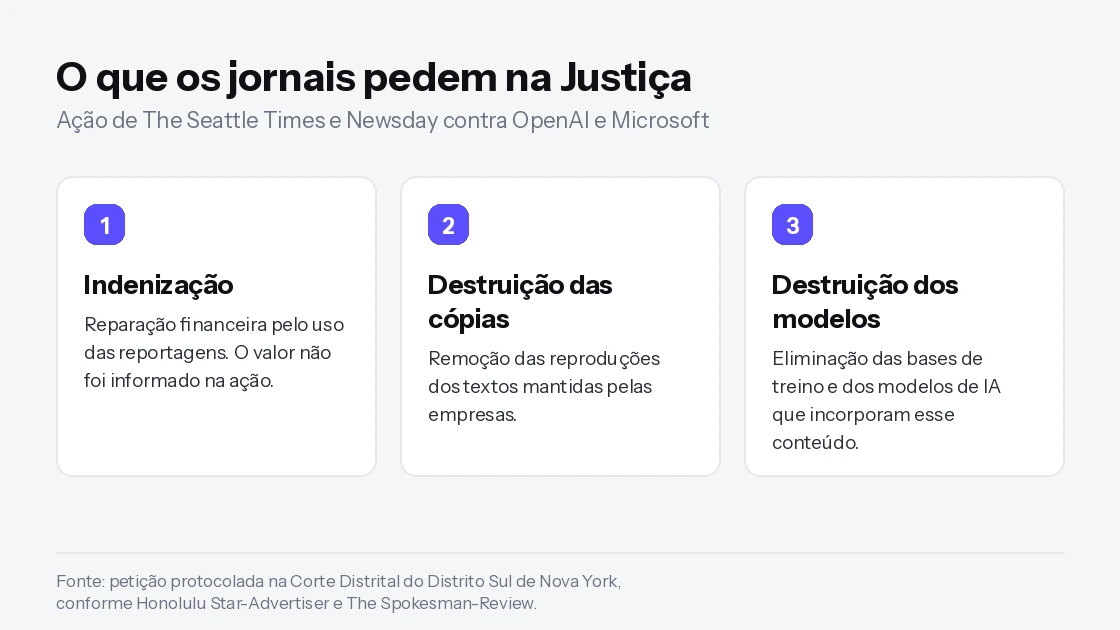
A indenização financeira era esperada, e o valor não foi divulgado. O pedido que muda a natureza do caso é outro: uma ordem judicial determinando a destruição das cópias das obras, das bases de treino que as contêm e dos modelos de IA que as incorporam.
Vale entender o que isso significa na prática. Um modelo de linguagem não guarda os textos em uma pasta de onde seja possível apagar um arquivo. O treinamento ajusta bilhões de parâmetros numéricos a partir dos dados, e o resultado é um objeto único e indivisível.
Não existe, hoje, uma técnica consolidada para remover de um modelo já treinado a contribuição de um conjunto específico de textos. Retirar o material implicaria, na leitura mais direta do pedido, treinar de novo — um processo que custa centenas de milhões de dólares e meses de trabalho.
Não há decisão conhecida que tenha imposto essa medida a um modelo comercial de grande porte, e as duas empresas ainda vão contestar o pedido. Mesmo assim, ele eleva o custo de um eventual acordo — e é por isso que cada nova ação desse tipo é acompanhada de perto pelo setor.
Como OpenAI e Microsoft responderam
A OpenAI manteve a linha que vem sustentando desde 2023. Segundo a empresa, seus modelos são treinados com dados publicamente disponíveis e a prática está amparada pelo fair use — a doutrina do direito norte-americano que permite o uso de obra protegida sem autorização em determinadas situações, como pesquisa, crítica e usos transformativos.
É importante registrar que o fair use não tem equivalente direto no Brasil. A Lei de Direitos Autorais brasileira trabalha com uma lista fechada de limitações, bem mais restrita do que o teste aberto aplicado pelos tribunais americanos.
A Microsoft adotou tom conciliador. Em nota, a empresa disse estar surpresa com a ação, afirmou reconhecer a importância do jornalismo local e se declarou disposta a sentar e explorar soluções para esse tipo de disputa.
A resposta da Microsoft tem um contexto que o TechCrunch registrou: Microsoft e OpenAI já financiaram projetos jornalísticos e bolsas do próprio Seattle Times. Financiar e ser processado pelo mesmo veículo descreve bem o estágio atual da relação entre plataformas de IA e imprensa.
Nem todos os veículos escolheram o litígio. Como registra o Engadget, parte da imprensa preferiu fechar acordos de licenciamento com empresas de IA em vez de ir à Justiça.
O que ainda não foi respondido
O valor da indenização pedida não foi informado. Também não há prazo definido: ações de direito autoral contra empresas de IA se acumulam nos Estados Unidos desde 2023, quando o New York Times abriu a sua.
Não há decisão sobre o mérito: nada do que os jornais alegam foi reconhecido por um juiz, e as duas empresas ainda vão apresentar defesa. Também não está claro se o caso caminha para acordo — o tom da nota da Microsoft sugere abertura, mas nenhuma das partes anunciou negociação.
Por fim, não há qualquer indicação de que os produtos citados na ação sejam interrompidos, restringidos ou alterados enquanto o processo corre. ChatGPT e Copilot seguem operando normalmente.
O que isso muda para a sua empresa
No curto prazo, nada muda na tela. Quem usa ChatGPT, Copilot ou qualquer assistente construído sobre esses modelos vai continuar usando exatamente como usava ontem. Não há liminar, não há suspensão e não há mudança de produto anunciada.
O efeito prático aparece em outro lugar: no contrato. Vale abrir os termos de uso do fornecedor de IA que a sua empresa contratou e procurar a cláusula de indenização por propriedade intelectual — o compromisso de que o fornecedor assume a defesa jurídica caso o cliente seja acionado por causa do conteúdo gerado pela ferramenta.
Vários fornecedores corporativos oferecem essa proteção, quase sempre restrita aos planos pagos e com condições específicas. Se a equipe usa a versão gratuita de um assistente para produzir material que vai para o site ou para uma proposta comercial, essa cobertura provavelmente não existe.
Há ainda um segundo ponto, mais imediato e independente do processo: a atribuição falsa. A mesma alegação que os jornais levaram à Justiça — modelos inventando informação e apresentando-a como se viesse de uma fonte real — vale para dados sobre a sua empresa, seus preços e seus prazos. Conteúdo gerado por IA que sai com a marca do negócio precisa passar por revisão humana antes de ser publicado.
Nas próximas semanas, três tarefas dão conta do essencial: identificar quais ferramentas de IA estão em uso na empresa e em qual plano, verificar se o contrato cobre propriedade intelectual, e definir quem revisa o que a IA escreve antes de publicar. É a mesma disciplina de decidir pelo problema, e não pela ferramenta da moda, que orienta um primeiro projeto de IA sem queimar dinheiro.
A lição de fundo é sobre dependência de fornecedor. Ferramentas de IA generativa entraram rápido na rotina das empresas, mas a base jurídica sobre a qual elas foram construídas ainda está sendo decidida em tribunal. Isso não é motivo para parar de usá-las — é motivo para saber, por escrito, quem responde pelo quê. A mesma pergunta aparece quando o assunto é a concentração da infraestrutura de IA em poucas mãos ou quando um novo modelo chega prometendo substituir o anterior.
Fontes
- Seattle Times and Newsday are the latest publications to sue OpenAI and Microsoft — TechCrunch
- Two more news organizations sue OpenAI and Microsoft for copyright infringement — Engadget
- Seattle Times, Newsday sue OpenAI, Microsoft, alleging copyright infringement — Honolulu Star-Advertiser
- The Seattle Times sues OpenAI, Microsoft over copyright infringement — The Spokesman-Review
- Seattle Times sues Microsoft and OpenAI, alleging they trained their AI on its journalism — GeekWire